` ajaxHooker.filter([ {url: '/plaManager/sysMenu/sysUserMenu'} ]);
ajaxHooker.hook(async (request) => { request.response = async (res) => { console.log(res.responseText); }; }); ` 调试后发现 其他请求全部挂了
感谢反馈,已于1.2.3修复,请再测试下有没有问题。
上面问题已修复,但是还有其他的问题导致filter出现问题
hook回调返回的reqest的url 有时候是 https://xxxx 有时候是 /api/xx/yyy 有时候是 /api/yyy?kk
如果请求的地址是 https://ebooking.ctrip.com/ebkovsassembly/api/trace/set POST 的时候 filter里面url 如果是 /^/ebkovsassembly/api/trace/set/ 的时候,被直接过滤掉了
url这个应该是正常的,库抓取的是原请求的调用参数,不一定是完整地址,取决于代码里是怎么写的,相对地址也可以解析。你这个应该是正则表达式的写法不对,^开头就是要求相对地址,原请求是绝对地址所以被过滤,这个逻辑没问题吧,如果希望相对和绝对都能hook到,应该把^号去掉,我描述里面有说明url无需完全匹配。
url这个应该是正常的,库抓取的是原请求的调用参数,不一定是完整地址,取决于代码里是怎么写的,相对地址也可以解析。你这个应该是正则表达式的写法不对,^开头就是要求相对地址,原请求是绝对地址所以被过滤,这个逻辑没问题吧,如果希望相对和绝对都能hook到,应该把^号去掉,我描述里面有说明url无需完全匹配。
额,明白了,因为我在控制台网络监控看到的接口都是绝对地址,我还以为库里面做了特殊处理,才导致url不一致,那看来应该是他发起接口请求的时候,有时候是用的是绝对地址,有时候用的相对地址,写正则习惯了用^,没想到会这里出问题了
还有一种请求无法被劫持到,
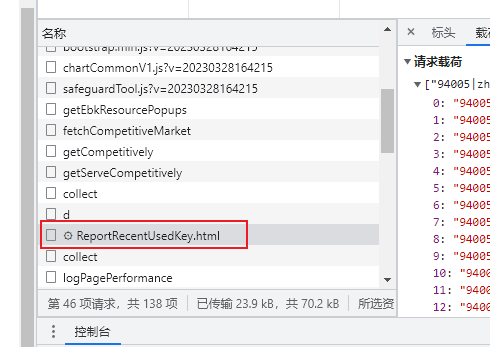
https://www.ctrip.com/m/i18n/ReportRecentUsedKey.html 是以html形式做的接口,response就是一个OK,不过这种情况比较稀少,为这个单独放开html过滤好像并不划算
https://www.ctrip.com/m/i18n/ReportRecentUsedKey.html 是以html形式做的接口,response就是一个OK,不过这种情况比较稀少,为这个单独放开html过滤好像并不划算
这个不是xhr/fetch请求吧,html、图片等属于网站资源了,库是通过劫持相关API来捕获请求的,不通过xhr/fetch获取的资源自然无法被捕获。纯js是没法劫持这类资源的,必须借助浏览器扩展实现(webRequest,最新的MV3标准打算移除这个API),油猴只在beta版里提供了相关GM函数,脚本猫未实现。由于这类资源通常在html源码里就能找到,只需要参数的话可以在页面元素里找找,修改返回值这种就做不到了。
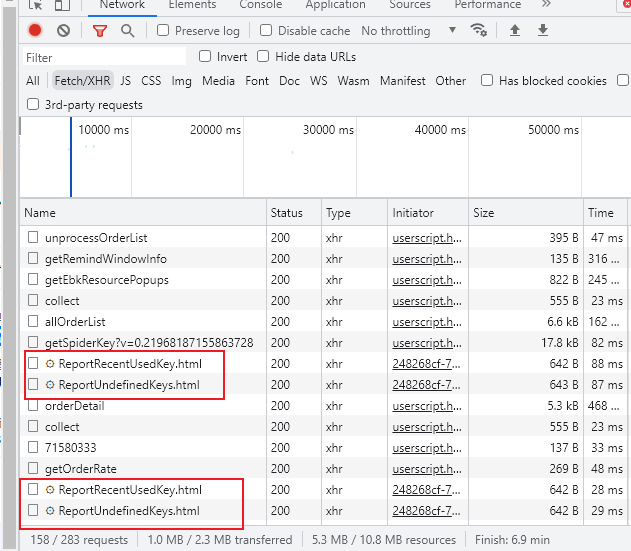
还真是xhr/fetch请求,我是选择了xhr/fetch过滤的,携程的反扒机制做得是真好,把我快搞吐血了,还有各种isTrust验证
还真是xhr/fetch请求,我是选择了xhr/fetch过滤的,携程的反扒机制做得是真好,把我快搞吐血了,还有各种isTrust验证
这种带齿轮的是Service Worker,相当于另一个线程里发起的请求,使用缓存来管理,脚本是没法处理的。